训练
-
已有NAS和对象存储,历史数据如何用于AI训练:发现、筛选与按需供给
很多企业建设 AI 平台时,真正有价值的数据其实已经保存在多套 NAS 和对象存储中。若把全量迁移作为训练前提,项目可能先花数月搬运并生成新的副本;若让算法团队直接访问所有旧系统,又会遇到路径分散、权
-
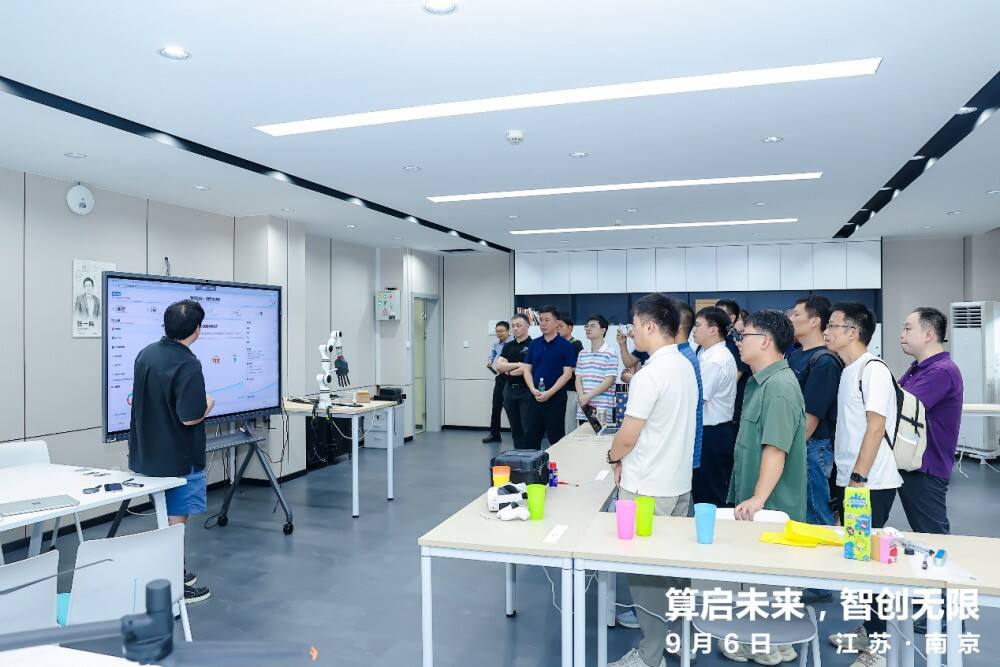
昇腾开发者高校训练营在东南大学正式结营
【2026年9月6日,南京】以“国产算力人才培养与校企协同创新”为主题的媒体活动走进东南大学九龙湖校区。本次活动同步举行2026年华为ICT学院昇腾开发者高校训练营闭幕式,百余名东南大学学子顺利完成本
-
MIT发明新型预训练方法GeoPT使人工智能模型可以模拟更广泛的现实世界
盖世汽车讯人工智能模型功能强大,可以胜任写作、图像生成和创建3D模型等诸多任务。但在测试机器人或车辆设计在各种环境下的性能时,它们的作用就显得有限了,因为它们对物理的理解远不如对像素或文本的理解。 为了构建一个能够可靠地模拟各种物理场景的...
-
AI训练数据走向 "货架化":艺恩数据市场上线,30+数据集支持浏览试用
8月16日,艺恩【数据市场】正式上线,首批 34 个成品数据集公开上架,覆盖具身本体·Ego 数据、视频数据、社媒数据、电商数据、及文本语料五大类别。客户无需注册、无需联系销售,即可完整查阅每个数据集
-
解析长尾挑战:Mobileye如何将边缘案例转化为定向训练
随着自动驾驶汽车在全球范围内加速部署,其现有技术的性能瓶颈也日益凸显。近期,自动驾驶系统在面对非常规或不确定场景时,表现受限的新案例不断涌现。自动驾驶技术研发人员将这类工况称作“长尾效应”——该术语源自于统计学指代难以建模的边缘案例。 能...
-
国产万卡训练!推理性能突破!摩尔线程新架构“花港”与路线图重磅亮相
2025年12月20日,摩尔线程首届MUSA开发者大会在北京中关村国际创新中心正式开幕。作为国内首个聚焦全功能GPU的开发者技术盛会,大会系统展示了摩尔线程以自主MUSA统一架构为核心的全栈技术成果,全面展现公司在高端全功能GPU领域的关键突破与前瞻布局。本次发布的核心成果包括: 1、新架构“花港”亮相:全功能G
-
Trainium3 UltraServers正式发布,助力客户更快更省地训练和部署AI模型
北京——2025年12月4日 亚马逊云科技在2025 re:Invent全球大会上,宣布Amazon EC2 Trainium3 UltraServers(下称Trn3 UltraServers)现已正式可用,由亚马逊云科技首款3nm AI芯片驱动,为不同规模的企业提供运行高强度AI训练与推理工作负载的能力,帮助客户更
-
闪迪参展CPSE2025:破解智能家居、无人机与大模型训练的存储密码
CPSE(China Public Security Expo)安防展会,作为全球领先的安防行业盛会之一,每次举办都吸引着全球数以千计的安防科技企业与行业精英。自创办以来,CPSE已成为展示最新安防技术和产品的平台,涵盖了智慧视频、智能安防、公共安全、大数据分析、人工智能等多个领域。展会吸引了来自全球的专业观众和媒体,
-
国内最大人形机器人训练场在京启用 我国现存超98万家机器人相关企业
近日,国内最大人形机器人训练场在北京石景山正式投入运营,该训练场占地面积上万平方米,年产数据量超600万条。这一重要基础设施的落成,既是我国人形机器人产业的“关键落子”,也为全国各地训练场建设提供了“北京样本”,将加速人形机器人“具身大脑”...
-
丰田研究院研发出全新机器人仅需一次训练便能习得类人技能
盖世汽车讯虽然机器人在探索遥远行星、执行复杂手术等技术上表现卓越,但是它们仍难以胜任若干基本的人类任务。其中最严峻的挑战之一是关于灵巧性的问题,即抓取、握持和操作物体的能力。而这一局面如今已被打破。据外媒报道,马萨诸塞州丰田研究院的科学家已...
-
聚焦大模型训练效率提升 北大依托昇腾突破细粒度混合并行技术
在人工智能大模型迅猛发展的当下,大模型参数和计算量呈指数级增长,大规模深度学习模型的训练离不开多硬件设备的分布式计算。在鲲鹏昇腾科教创新卓越中心的算力支持下,北京大学计算机学院崔斌教授团队创新研发了面向大模型的高效分布式训练框架,大幅提升了大规模分布式训练模型的效率。 针对模型训练任务的多样性和复杂性所带来的负载
-
华为云盘古预测大模型首创 Triplet Transformer 统一预训练架构
6月20日,在华为开发者大会2025(HDC 2025)上,华为常务董事、华为云计算CEO张平安重磅发布盘古大模型5.5,五大基础模型全面升级,为行业提供全新价值。其中,盘古预测大模型持续探索复杂工业场景下模型泛化的难题,帮助工业领域实现各种工艺优化,系统寻优,解决生产难题。 本次盘古预测大模型的关键升级
-
铨兴科技助力671B DeepSeek R1训练成本再降95%!
近日,DeepSeek凭借其低成本、高性能的大模型研发成果,迅速引发了全球科技界的关注。在AI大模型训练领域,显存墙和通信墙一直是制约技术普及的核心瓶颈。 铨兴科技基于自研技术创新,通过超显存融合技术,打破显存墙,可将单机显存最高扩展至8TB,成功实现了DeepSeek R1 671B大模型极低成本的全参训练,成